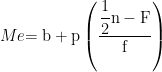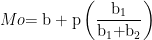Thursday, January 21, 2016

Tugas ke-4 Softskill Pengantar Statistika

Distribusi Peluang Kontinu
A.   Pengertian Distribusi Peluang Kontinu
Distribusi peluang kontinu adalah peubah acak yang dapat memperoleh semua nilai pada skala kontinu. Ruang sampel kontinu adalah bila ruang sampel mengandung titik sampel yang tak terhingga banyaknya. Syarat dari distribusi kontinu adalah apabila fungsi f(x) adalah fungsi padat peluang peubah acak kontinu X yang didefinisikan di atas himpunan semua bilangan riil R bila:

1.  F(x) ≥ 0 untuk semua x є R

∞

2.   ∫     𝑓(𝑥)𝑑𝑥 = 1

∞

∞

3.      𝑃(𝑎 < 𝑋 < 𝑏) =  ∫           𝑓(𝑥)𝑑𝑥

∞


B.    Konsep dan Teorema Distribusi

1. Distribusi Normal

Distribusi Normal (Gaussian) mungkin merupakan distribusi probabilitas yang
paling penting baik dalam teori maupun aplikasi statistik. Distribusi ini paling banyak
digunakan sebagai model bagi data riil di berbagai bidang yang meliputi antara lain
karakteristik fisik makhluk hidup (berat, tinggi badan manusia, hewan, dll). Terdapat
empat alasan mengapa distribusi normal menjadi distribusi yang paling penting :

a. Distribusi normal terjadi secara alamiah.

b. Beberapa variabel acak yang tidak terdistribusi secara normal dapat dengan mudah
    
ditransformasi menjadi suatu distribusi variabel acak yang normal.

c. Banyak hasil dan teknik analisis yang berguna dalam pekerjaan statistik hanya bisa
    
berfungsi dengan benar jika model distribusinya merupakan distribusi normal.

d. Ada beberapa variabel acak yang tidak menunjukkan distribusi normal pada
    
populasinya, namun distribusi dari rata-rata sampel yang diambil secara random

dari populasi tersebut ternyata menunjukkan distribusi normal.

Distribusi Normal disebut juga Gausian distribution adalah salah satu fungsi distribusi peluang berbentuk lonceng seperti gambar berikut. 


Berdasarkan gambar di atas, distribusi Normal akan memiliki beberapa ciri diantaranya: 
a. Kurvanya berbentuk garis lengkung yang halus dan berbentuk seperti genta.  
b. Simetris terhadap rataan (mean). 
c. Kedua ekor/ ujungnya semakin mendekati sumbu absisnya tetapi tidak Pernah                  memotong.  
d. Jarak titik belok kurva tersebut dengan sumbu simetrisnya sama dengan σ 
e. Luas daerah di bawah lengkungan kurva tersebut dari - ~ sampai + ~ sama dengan                 1 atau 100 %.

          
    2. Distribusi Chi-Kuadrat (𝝌𝟐)

Distribusi chi-kuadrat merupakan distribusi yang banyak digunakan dalam sejumlah  prosedur  statistik  inferensial.  Distribusi  chi-kuadrat  merupakan  kasus khusus dari distribusi gamma dengan faktor bentuk 𝛼 = 𝑣/2, dimana v adalah bilangan bulat positif dan faktor skala 𝛽 = 2.

Jika variabel acak kontinu X memiliki distribusi chi-kudrat dengan parameter v, maka fungsi kepadatan probabilitas dari X adalah :


Parameter n disebut angka derajat kebebasan (degree of freedom/df) dari X. Sedangkan fungsi distribusi kumulatif chi-kuadrat adalah :

Berikut  ini  diberikan  rumusan  beberapa  ukuran  statistik  deskriptif  untuk distribusi chi-kuadrat
3. Distribusi F
        Menurut Gasperz (1989:251), secara teori sebaran F merupakan rasio dari dua sebaran chi kuadrat yang bebas. Oleh karena itu peubah acak F diberikan sebagai:
                                                                                 
  𝑋2 =  𝑛𝑖𝑙𝑎𝑖 𝑑𝑎𝑟𝑖 𝑠𝑒𝑏𝑎𝑟𝑎𝑛 𝑐ℎ𝑖 𝑘𝑢𝑎𝑑𝑟𝑎𝑡 𝑑𝑒𝑛𝑔𝑎𝑛 𝑑𝑒𝑟𝑎𝑗𝑎𝑡 𝑏𝑒𝑏𝑎𝑠 𝑉1 = 𝑛1 െ 1  
 𝑋2 =  𝑛𝑖𝑙𝑎𝑖 𝑑𝑎𝑟𝑖 𝑠𝑒𝑏𝑎𝑟𝑎𝑛 𝑐ℎ𝑖 𝑘𝑢𝑎𝑑𝑟𝑎𝑡 𝑑𝑒𝑛𝑔𝑎𝑛 𝑑𝑒𝑟𝑎𝑗𝑎𝑡 𝑏𝑒𝑏𝑎𝑠 𝑉2 = 𝑛2 െ 1 Oleh  karena itu      sebaran F  mempunyai dua derajat bebas yaitu 𝑉1 𝑑𝑎𝑛 𝑉2.

Misal :
Kita ingin mengetahui nilai F dengan derajat bebas 𝑉1 = 10 dan 𝑉2 = 12, maka jika 𝛼 = 0,05 dari tabel F diperoleh nilai 𝐹0,05 (10,12) = 2,75 

Cara Menggunakan Tabel Z


Tabel Z sebenarnya digunakan untuk memudahkan sobat dalam menghitung peluang (kerapatan probablitas) dari  distribusi normal. Rumus fungsi kerapatan probabilitas dari distribusi normal adalah

rumus fungsi distribus normal (tabel z)

Dimana μ adalah rata-rata, σ adalah standar deviasi dan π = 3,14159. Grafik fungsi distribusi normalnya sendiri seperti di bawah ini

tabel z or z table

Grafik fungsi distribusi normal tersebut di atas membentang dari minus tak hingga hingga tak hingga. Hanya saja, semakin jauh dengan rata-rata (M1), nilai probabilitas akan semakin mendekati nol. Mungkin kalau sobat hanya menghitung nilai probabilitas dari suatu angka/titik mungkin ngga begitu susah, tinggal dimasukkan ke rumus (susah juga sih)

rumus fungsi distribus normal (tabel z)
Nah susahnya sobat, misal sobat menghitung probabilitas dari suatu range. Misal saja kita pakai contoh soal distribusi normal berikut

Rata-rata produktivitas padi di Aceh tahun 2009 adalah 6 ton per ha, dengan simpangan baku (s) 0,9 ton.  Jika luas sawah di Aceh 100.000 ha dan produktivitas padi berdistribusi normal (data tentatif), tentukan. Berapa luas sawah yang produktivitasnya lebih dari 8  ton? Sobat bisa saja ko pakai rumus berikut

menghitung probabilitas
Super njlimet kan kalau harus ngitung integral kaya gitu. Disinilah gunanya tabel Z. Kita hitung dulu nilai z dari soal di atas dengan rumus

Setelah itu tinggal kita gunakan tabel Z untuk menentukan probabilitasnya. Cara menggunakan tabel Z nya sebagai berikut

  1. Caranya buka Tabel Z dan lihat  sel pada perpotongan baris 2,20 dan kolom 0,02.
  2.  Sobat akan menemukan sebuah angka yaitu 0,98679 dan bila dijadikan persen menjadi 98,679%.
  3. Angka yang sobat temukan di tabel z tersebut menunjukkan  luas di bawah kurva normal baku dari titik 2,22 ke kiri kurva yaitu 98,679%. Karena luas seluruh di bawah kurva normal adalah 100%, maka luas dari titik 2,22 ke kanan kurva adalah 100% – 98,679% = 1,321% (arsir warna hitam pada gambar).  Oleh karena itu, luas sawah yang produktivitasnya lebih dari 8 ton adalah 1,321%, yaitu (1,321/100) x 100.000 ha = 1321 ha

Penggunaan Tabel t
Struktur tabel t yang umum adalah sebagai berikut
https://junaidichaniago.files.wordpress.com/2010/05/tabel-t.jpg 
Judul masing-masing kolom mulai dari kolom kedua (angka yang dicetak tebal) dari tabel tersebut adalah nilai probabilita (tingkat/taraf signifikansi). Nilai yang lebih kecil 
menunjukkan probabilita satu arah (satu sisi) sedangkan nilai yang lebih besar menunjukkanprobabilita kedua arah (dua sisi). Misalnya pada kolom kedua, angka 0,25 adalah probabilita satu arah sedangkan 0,50 adalah probabilita dua arah. 
Selanjutnya, judul masing-masing baris adalah derajat bebas (db) atau degree of freedom (df).   Seperti terlihat pada gambar diatas yang dimulai dari angka 1, dan biasanya pada buku-buku
statistik/ekonometrik sampai angka 200

Penggunaan tabel F
DERAJAT KEBEBASAN (DEGREE OF FREEDOM )
Derajat kebebasan mempunyai dua makna yang berbeda. Dalam kaitannya dengan 
distribusi statistic untuk memberikan nama dari salah satu parameternya. Dalam kaitannya dengan kecocokan model, derajat kebebasan menunjuk pada jumlah informasi yang independen yang ada digunakan untuk membuat estimasi terhadap informasi yang lain. Umumnya kita memulai jumlah derajat kebebasan dengan data. Semakin suatu prosedur atau model cocok,maka jumlah derajat kebebasan semakin kecil.Penghitungan derajat kebebasan dilakukan melalui ukuran sampel. Derajat kebebasan merupakan pengukuran jumlah informasi dari data sample yang telah digunakan. Setiap penghitungan statistik dilakukan dari suatu sampel tertentu maka satu derajat kebebasan digunakan. Setiap rumus dalam SPSS cara menghitung derajat kebebasan (DF /Degree of Freedom) berbeda, misalnya dalam Chi Square untuk menghitung DF digunakan rumus (C-1) x (R-1); sedang ntuk uji t sampel bebas untuk menghitung DF digunakan rumus n-2; untuk uji t sampel berpasangan untuk menghitung DF digunakan rumus n-1 dstnya

http://rumushitung.com/2013/01/23/tabel-t-dan-cara-menggunakannya/
www.stasistikadasar.com

Thursday, November 26, 2015

Tugas ke-3 Softskill Pegantar Statistika

TEKNIK SAMPLING PROBABILITAS DAN NON-PROBABILITAS


TEKNIK SAMPLING PROBABILITAS


Pengertian Teknik Sampling Probabilitas
Teknik sampling probabilitas (probability) merupakan teknik yang memberikan peluang  atau kesempatan yang sama bagi setiap unsur (anggota) populasi untuk dipilih menjadi anggota sampel. Selain itu probability sampling merupakan pemilihan sampel tidak dilakukan secara subjektif, dalam arti sampel yang terpilih tidak didasarkan semata-mata pada keinginan si peneliti sehingga setiap anggota populasi memiliki kesempatan yang sama (acak) untuk terpilih sebagai sampel. Dengan demikian diharapkan sampel yang terpilih dapat digunakan untuk mendug karakteristik populasi secara objektif..Teknik Probilitas ini bertujuan mendapatkan data seakurat mungkin agar diketahui jarak pasti dari kondisi ideal. (Asep, 2005)

Metode Penarikan Sampel Probabilitas
            Terdapat empat metode dalam penarikan sampel probabilitas. Metode dalam penarikan sampel probabilitas akan dijelaskan sebagai berikut: (Asep, 2005)
1.        Sampel Acak Sederhana
Metode sampel acak sederhana merupakan suatu prosedur yang memungkinkan setiap elemen dalam populasi akan memiliki peluang yang sama untuk dijadikan sampel.
2.        Sampel Berstrata
Metode penarikan sampel berstrata merupakan suatu prosedr penarikan sampel berstrata yang dalam hal ini suatu subsampel –subsampel acak sederhana ditarik dari setiap strata yang kurang lebih sama dalam beberapa karakteristik. Ada dua macam penarikan sampel berstrata yaitu, proporsional dan Non-Proporsional.
3.        Sampel Berkelompok
Metod penarikan data sampel berkelompok merupakan suatu prosedur penarikan sampel probabilitas yang memilih sub-populasi yang disebut cluster, kemudian setiap elemen didalam kelompok dipilih sebagai anggota sampel
4.        Sampel Sistematik
Metode penarikan sampel sistematik, populasi dibagi dengan ukuran sampel yang diperlukan (n) dan sampel diperoleh dengan cara mengambil setiap subyek ke-n.


TEKNIK SAMPLING NON-PROBABILISTIK


Pengertian Teknik Sampling Non-Probabillity
            Teknik non-probilitas merupakan teknik yang tidak memberikan peluang atau kesempatan sama bagi setiap unsur atau anggota populasi untuk dipilih menjadi sampel. Teknik ini terdiri sampling sistematis, sampling kuota, sampling aksidental, sampling purposive, sampling jenuh dan snowball sampling. nonprobability sampling seringkali menjadi alternative pilihan dengan pertimbangan yang terkait dengan penghematan biaya, waktu dan tenaga serta keterandalan subjektifitas peneliti. Di samping itu pertimbangan lainnya adalah walaupun probability sampling mungkin saja lebih unggul dalam teori, tetapi dalam pelaksanaannya seringkali dijumpai adanya beberapa kesalahan akibat kecerobohan dari si pelaksananya. Dalam penggunaan non-probability sampling, pengetahuan, kepercayaan dan pengalaman seseorang seringkali dijadikan pertimbangan untuk menentukan anggota populasi yang akan dipilih sebagai sampel. Pengambilan sampel dengan memperhatikan factor-faktor tersebut menyebabkan tidak semua anggota populasi memiliki kesempatan yang sama untuk dipilih secara acak sebagai sampel. Dalam prakteknya terkadang ada bagian tertentu dari populasi tidak dimasukkan dalam pemilihan sampel untuk mewakili populasi.

Teknik Pengambilan Sampel Non-Probability
Terdapat  lima teknik pengambilan teknik sampling non probabilistik. Berikut ini adalah uraian penjelasan dari ke lima teknik sampling non probabilistik: (Al-Assaf, 2009)
1.        Teknik Haphazard
Teknik hapzard adalah teknik pengambilan sampel dimana satuan pengamatannya diperoleh secara sembarangan atau sedapatnya.
2.        Teknik Voluntary
Teknik voluntary adalah teknik yang dilakukan jika satuan sampling dikumpulkan atas dasar sukarela.
3.        Teknik Purposive
Teknik purposive merupakan teknik  pengambilan sampel yang dilakukan dengan memilih satuan sampling atas dasar pertimbangan sekelompok pakar di bidangilmu yang sedang diteliti
4.        Teknik Snowball
Teknik snowball merupakan teknik pengambilan sampel dimana satuan pengamatan diambil berdasarkan informasi dari satuan pengamatan sebelumnya yang sudah terpilih.
5.        Teknik Kuota
Teknik pengambilan sampel ini banyak diterapkan pada penelitian pasar dan penelitian pengumpulan pendapat (opinion poll) atau jejak pendapat. Teknik dilakukan dengan melakukan penjatahan terhadap kelompok satuanpengamatan secara berjenjang.

Friday, November 6, 2015

Tugas ke-2 Softskill Pegantar Statistika

1. Mean 
     Mean adalah rata - rata, atau lebih jelasnya mean adalah rata - rata nilai yang dapat kita peroleh dari suatu informasi. berikut adalah data dari TDF / data tugas sebelumnya


Jadi nilai rata-rata nya 69.87
2. Median 
      Median atau nilai tengah adalah nilai pengamatan yang terletak ditengah data pengamatan setelah data diurutkan. Median membagi dua himpunan dari data pengamatan menjadi dua data pengamatan yang sama besarnya,50% data pengamatan terletak diatas median dan 50% lagi terletak dibawah median. Dalam data kali ini saya menggunakan data kelompok . Formula untuk menentukan median dari tabel data frekuensi adalah sebagai berikut : 
Me{\rm{ = b + p}}\left( {\dfrac{{\dfrac{{\rm{1}}}{{\rm{2}}}{\rm{n - F}}}}{{\rm{f}}}} \right)
b= Batas bawah kelas median
p= panjang kelas median 
n= ukuran sampel/banyak data
f= Frekuensi kelas median
F= Jumlah frekuensi kelas yang lebih kecil dari kelas median

jadi 
b=69,5
p=10
n=79
f=12
F=28


3. Modus
     Modus adalah data yang paling sering muncul.
Formula yang digunakan untuk menentukan modus dalam data berkelompok :
Mo{\rm =b+p}\left(\dfrac{{{\rm b}}_{{\rm 1}}}{{{\rm b}}_{{\rm 1}}{\rm +}{{\rm b}}_{{\rm 2}}}\right)
Mo    =Modus=Kelas Modal
b       =Batas bawah kelas modal
p       =Panjang kelas modal
Bmo    =Frekuensi kelas modus
b1    = Frekuensi kelas modus-frekuensi kelas sebelum kelas modus.
b2    = Frekuensi kelas modus-frekuensi kelas setelah kelas modus


4. Range
      Range adalah perbedaan antara data terbesar dengan data terendah yang terdapat pada sekelompok data
Range = 99-50 =49

5. Ragam 
     Rumus ragam 


Jadi 
Sehingga
Dan Perhitungannya seperti ini :

 
6. Simpangan Baku 

Rumus 

  
Jadi 


Pengertian dan cara menghitung Kemencengan Sebaran (Skewness), dan kecuraman kurva sebaran(Kurtosis)

A. Kemencengan Kurva Sebaran (Skewness)
     Skewness adalah derajat ketidak simetrisan suatu distribusi. Jika suatu kurva frekuensi suatu distribusi memiliki ekor yang lebih memaanjang ke kanan (dilihat dari meannya)maka dinyatakan menceng kanan (positif) dan jika sebaliknya maka menceng kiri (negatif). Secara perhitungan, skewness adalah momen ketiga terhadap mean. Distribusi normal (dan distribusi simetris lainnya, misalnya distribusi t atau Cauchy) memiliki skewness 0 (nol). 
Cara menghitungnya:


B. Kecuraman Kurva Sebaran 
     Merupakan derajat atau ukuran tinggi rendahnya puncak suatu distribusi data terhadap distribusi normalnya data. Jika bentuk kurva runcingberarti nilai data terkonsentrasi terhadap nilai rata-tata atau nilai penyebarannya kecil, sebaliknya jika bentuk kurva nya tumpul berarti nilai data tersebar terhadap nilai rata-rata atau nilai penyebaran besar. Keruncingan distribusi data ini disebut juga kurtosis.
Derajat keruncingan suatu distribusi frekuensi dapat dibedakan menjadi tiga, yaitu:
  •     Leptokurtis
Distribusi data yang puncaknya relatif tinggi atau bentuk distribusi yang ujungnya sangat runcing
  •     Mesokurtis
Distribusi data yang puncaknya tidak terlalu runcing atau tidak terlalu tumpul
  •     Platikurtis
Distribusi data yang puncaknya terlalu rendah atau terlalu mendatar